AI가 수능을 다 풀면, 우리는 모두 같은 실력일까?
같은 AI를 써도 사람마다 해낼 수 있는 일이 다른 이유를 행사장 입구와 마지막 한 자리에서 찾아봤습니다.
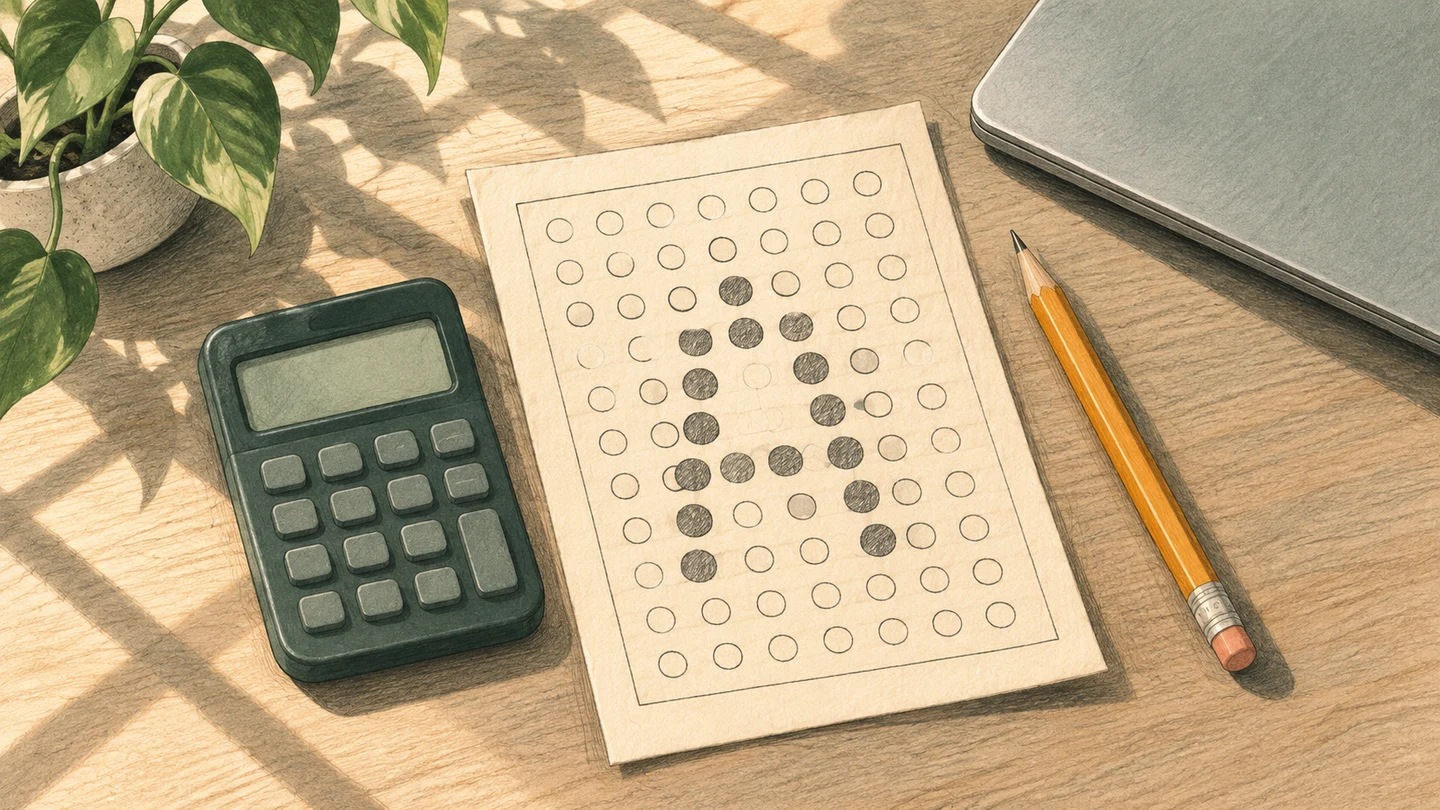
11월 15일, 올해 세무사 시험 수석 합격자가 1·2차 시험에서 생성형 AI를 이용해 부정행위를 했다고 시인하고 경찰에 자수했습니다. 후속 보도에 따르면 수정테이프에 숨긴 초소형 카메라로 시험 문제를 찍고, 개조한 계산기와 스마트폰을 이용해 자택 노트북으로 보냈습니다. AI가 낸 답은 옷에 붙인 작은 화면으로 확인한 것으로 전해졌습니다. 국세청은 16일 시험 무효와 5년간 응시자격 정지 처분 절차에 착수했습니다.
법학적성시험(LEET) 만점자 이진우 씨는 AI를 이용한 부정행위 의혹을 부인해 왔으며, 11월 19일 숨진 채 발견됐습니다. 경찰은 사망 이후에도 사실관계를 확인하기 위해 수사를 이어가겠다고 밝혔습니다. 20일 공개 보도 기준으로 부정행위 여부는 확인되지 않았습니다.
이 소식을 읽다가 다른 질문이 생겼습니다. 모두가 같은 AI를 쓸 수 있고 그 AI가 시험 문제를 전부 풀어준다면, 사람들의 실력도 비슷해질까요?
출처 · 한국일보, 세무사 시험 부정행위 수법과 수사 상황 · 국세청, 세무사 시험 무효 절차 개시 · YTN, LEET 만점자 사망 이후 수사 상황
계산기에 무슨 식을 넣을까요?
“참가자 120명을 네 줄에 똑같이 세우면 한 줄에 몇 명일까요?” 계산기에 120 ÷ 4를 넣으면 누구나 30을 얻습니다.
AI는 문제를 읽고 어떤 식을 쓸지 골라 답까지 씁니다. 2027학년도 수능 공개 문제를 사용한 민간 평가에서는 모델 16개 중 5개가 국어·수학·영어 평가 문항 147개를 모두 맞혔습니다. 시험 당일 공개된 정답표로 채점한 결과입니다.
모든 응시자가 그런 AI를 쓸 수 있다고 가정해 봅시다. 답안이 만점에 몰리면 점수표만으로 응시자 사이의 차이를 읽기 어려워집니다. 시험지에는 풀어야 할 문제가 이미 적혀 있습니다. 행사장에선 대개 “입장 줄이 너무 길어요”라는 말부터 듣습니다.
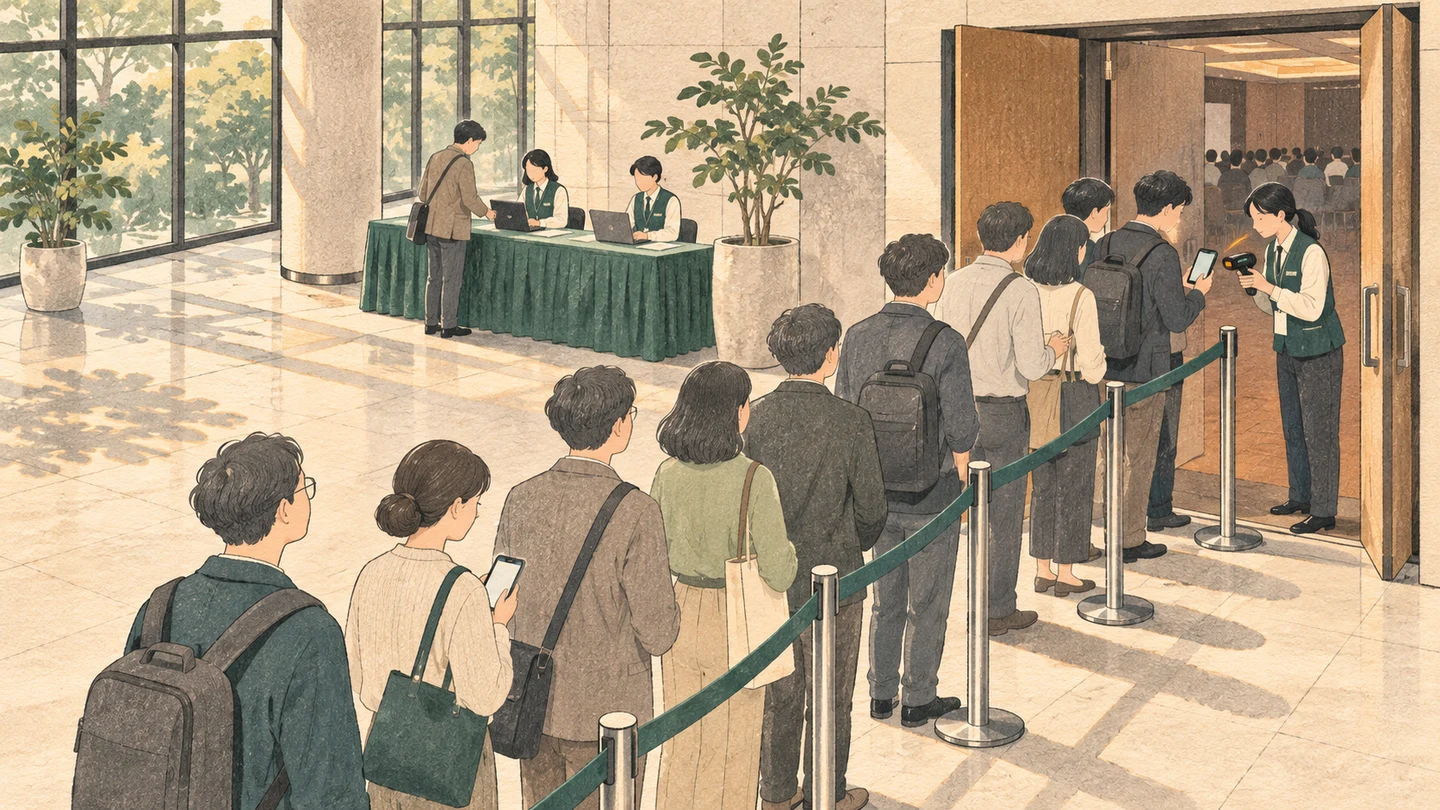
접수대에 문의가 몰릴 수도 있고, 입구에서 QR을 하나씩 확인하느라 줄이 길어질 수도 있습니다. QR 확인에서 막히는데 접수대를 늘리면 입구에 도착하는 사람만 더 늘어납니다. AI에 해결책을 묻기 전에 어디가 막혔는지부터 봐야 합니다.
출처 · 한국교육과정평가원, 2027학년도 수능 문제·정답 공개 · KSAT AI Benchmark, 모델별 결과와 평가 조건
마지막 한 자리를 두 사람이 예약하면
코딩을 배운 적 없는 행사 운영자가 AI로 예약 도구를 만들었다고 해봅시다. 이름을 입력하고 버튼을 누르니 예약 완료 화면이 뜹니다. 운영자가 다음으로 떠올린 건 행사 당일에 생길 법한 상황입니다. “마지막 한 자리를 두 사람이 동시에 눌렀을 때는 어떻게 되지?”
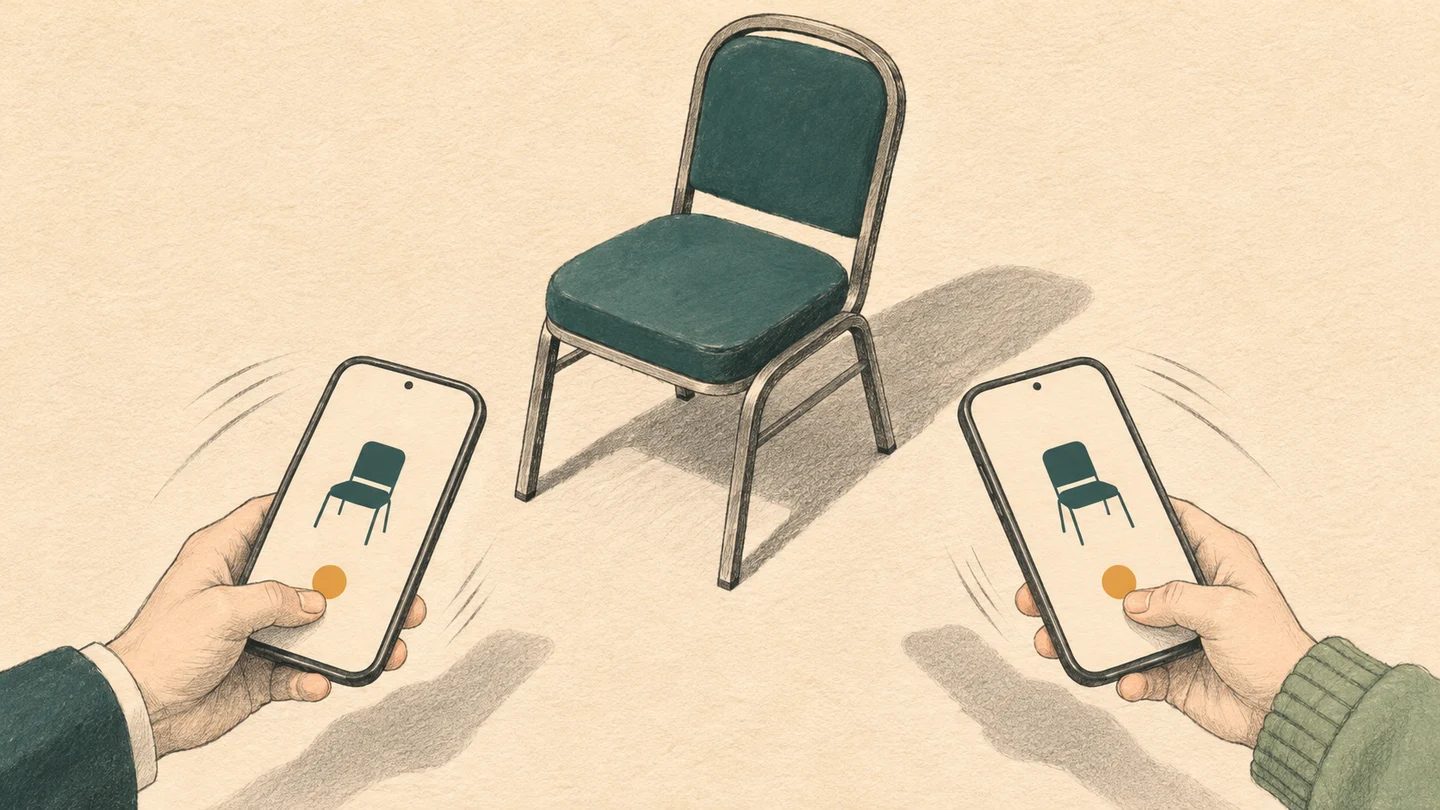
운영자는 AI에 두 요청이 겹치는 상황을 시험해 달라고 합니다. 예약 기록에 한 건만 남는지, 다른 참가자에게는 마감 안내가 뜨는지 확인합니다. 둘 다 예약됐다고 나오면 고친 뒤 같은 조건으로 다시 시험합니다. 행사 운영을 해본 사람이라면 코드를 읽기 어려워도 어떤 상황이 문제가 될지, 제대로 고쳤는지 무엇을 보고 판단할지 설명할 수 있습니다.
이 글에서 말하는 AI 활용 역량(AI competence)은 무엇을 맡길지 정하고, 필요한 맥락을 설명하고, 결과를 확인해 실제로 쓸 수 있는 상태까지 일을 끝내는 능력입니다. 예약 도구의 경우에는 “예약 페이지를 만들어 줘”라는 요청 뒤에 이어지는 일까지 포함합니다.
참고 · Dakan·Feller, AI Fluency Framework
같은 AI와 일해도 결과는 달랐습니다
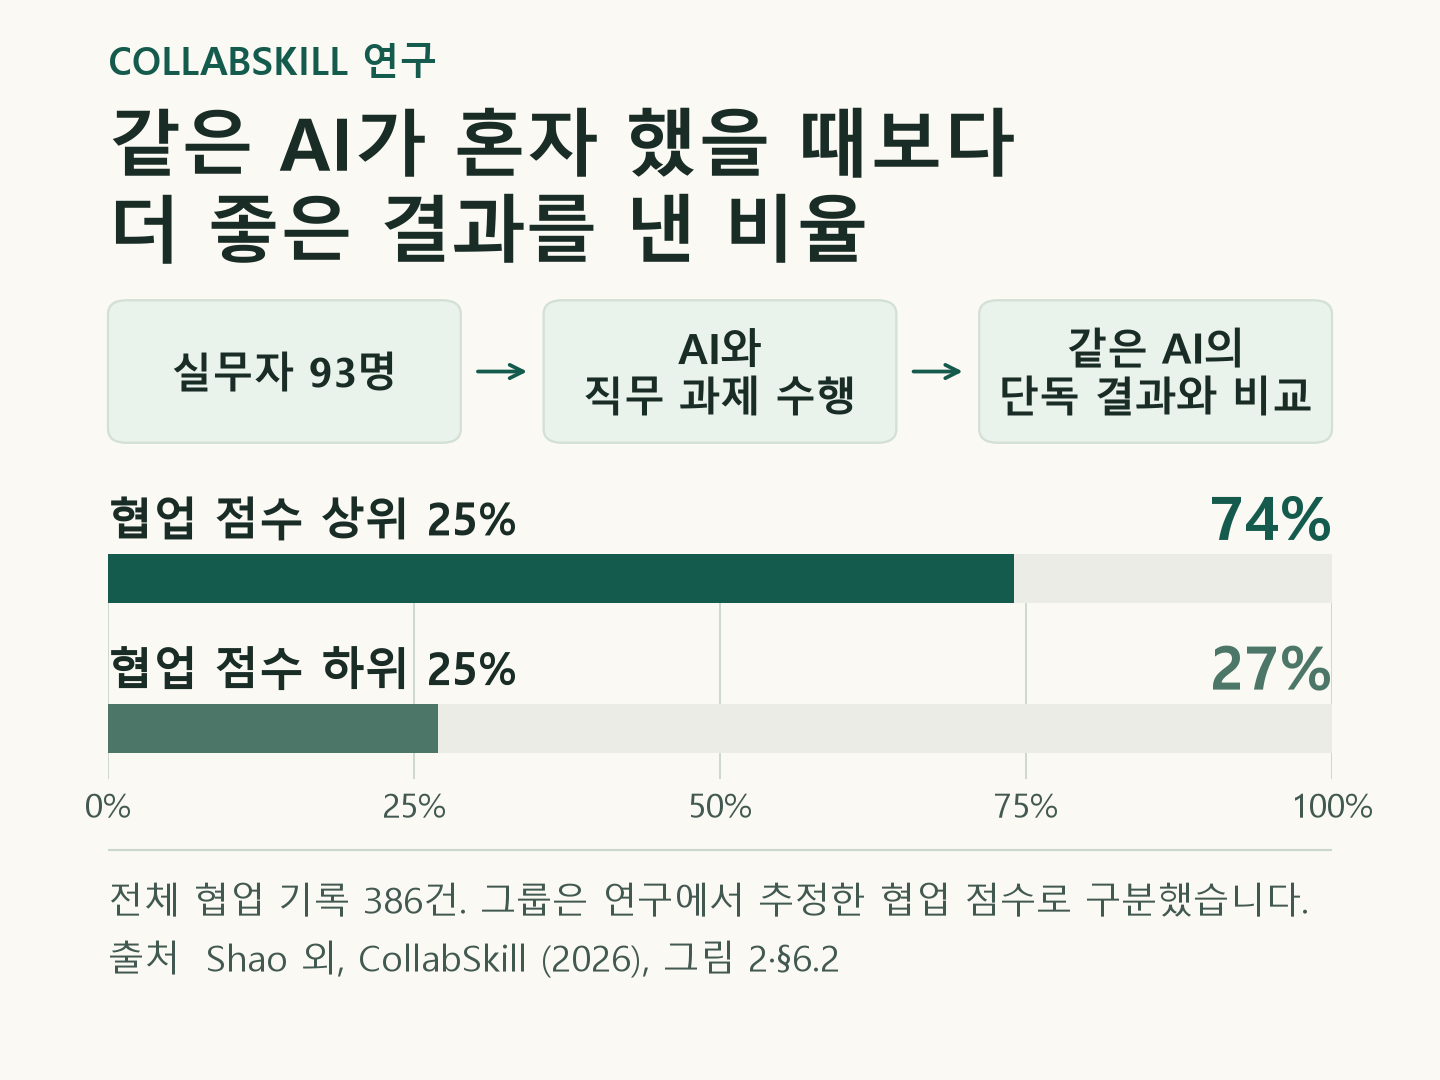
CollabSkill 연구진은 실무자 93명에게 각자의 직무와 관련된 일을 주고, 함께 작업할 AI 에이전트를 무작위로 짝지었습니다. 연구 전체에서 협업 기록 386건을 모았습니다. 결과를 비교할 때는 사람과 AI가 함께 만든 결과와 같은 AI가 같은 과제를 혼자 수행한 결과를 짝지었습니다. 연구진이 추정한 협업 점수 상위 25% 그룹은 작업의 74%에서 AI 단독 결과를 앞섰습니다. 하위 25% 그룹은 27%였습니다. 이 점수에는 참가자가 원래 그 일을 얼마나 잘하는지도 반영될 수 있습니다.
작업 기록을 보면 결과를 누가 읽을지 알려주거나 원하는 결과의 예시를 준 경우에 점수가 높은 편이었습니다. 대화를 몇 번 주고받았는지와 점수 사이에는 뚜렷한 관계가 없었습니다. 예약 도구를 만들 때도 “다시 만들어 줘”를 몇 번 더 말하는 것보다 “두 사람이 동시에 눌러도 예약은 한 건만 확정돼야 해”라는 조건이 일을 구체적으로 바꿉니다.
엠마 와일스와 케이틀린 크래니는 평소 코딩이 주업무가 아닌 컨설턴트 332명에게 파이썬 데이터 분석 과제를 줬습니다. 진행 중인 연구의 공개 초록에 따르면 AI를 쓸 수 있던 집단의 과제 점수가 34%p 높았습니다. 연구진은 참가자가 일을 어떻게 나누고, 생성된 코드를 어디까지 직접 수정하고, 결과를 어떻게 확인했는지도 살폈습니다. 다른 일에서도 비슷한 효과가 나타날지는 더 살펴봐야 합니다.
출처 · Shao 외, CollabSkill §6.2 및 부록 J · Wiles·Cranney, AI Competence as Human Capital 공개 초록
어디까지 해야 일이 끝날까요?
“예약 도구를 만들었다”는 말에는 여러 단계가 들어 있습니다. 예약 화면을 띄운 뒤에는 만석 처리와 취소를 시험해 볼 수 있습니다. 행사 당일 운영팀에 넘기려면 담당자가 예약 현황을 보고 취소된 자리를 처리할 수 있어야 합니다. 어디까지 필요한지 정하면 AI에 맡길 일도 달라집니다.
입장 줄도 마찬가지입니다. AI가 계산한 예상 대기 시간을 보고 입구의 확인 방식을 고를 수 있습니다. 바꾼 방식이 효과가 있었는지는 행사장에서 전후의 대기 시간을 재봐야 알 수 있습니다.
“AI로 이게 될까?”에서 시작하더라도, 답을 받은 뒤에는 “이걸 실제로 쓰려면 무엇을 확인해야 할까?”라는 질문이 남습니다. 예약 도구라면 마지막 한 자리를 두고 두 사람이 동시에 버튼을 눌러보는 일부터 시작할 수 있습니다.